Dossier
« Entraîner la prise d’indices visuels en lecture : rêve ou réalité ? »
Jean FOUCAMBERT
Les séries A et C d’ATEL, d’ELMO, d’ELSA puis, du dernier né des outils d’entraînement à la lecture produits par l’AFL, eisa, ont toujours eu comme objectifs de faire travailler sur la largeur, la vitesse et la précision de ce que perçoit l’œil, lors de ses points d’arrêt dans un texte. Cet article reprend certains éléments de l’article Perception et Lecture [1] et expose comment ces deux nouvelles séries de la plateforme eisa y répondent.
Rappelons tout d’abord que nous nous situons résolument dans la perspective abondamment expérimentée et théorisée par Alain Berthoz, longtemps titulaire de la chaire de physiologie de la perception du collège de France, pour qui l’intention semble bien être la base de l’action. Les neurophysiologistes les plus avertis considèrent le cycle perception-action comme indissociable. « L’exploration du monde visuel par un sujet serait définie par des schèmes anticipatoires définis comme des plans pour l’action perceptive » [2]. Cette grande place accordée à l’anticipation semble bien souvent exclue des recherches sur la lecture, déconnectant ainsi la perception de toute anticipation. Cependant, il semble pour le moins indispensable de greffer les travaux, recherches et outils sur les processus de lecture avec les résultats obtenus sur la perception visuelle - après tout, il est difficile de contredire la simple évidence que le traitement de la chaîne écrite, perçue d’abord et avant tout par les yeux, doit bien être congruent avec ce que l’on sait de la perception visuelle en général.
PERCEPTION ET LECTURE
1. Un petit rappel anatomique
Chez l’homme, la fovéa, petite dépression d’environ 1,2 mm de diamètre, située au centre de la tache jaune ou macula, se caractérise par une grande finesse de son pouvoir de discrimination spatiale, ainsi que par son importance pour la vision des couleurs. Elle contient exclusivement des cônes, tous les éléments non récepteurs ainsi que les vaisseaux sanguins étant refoulés à sa périphérie, ce qui a l’avantage de laisser la lumière frapper directement les récepteurs. Leur densité est très élevée. Chaque cône est connecté à une cellule bipolaire. Au fur et à mesure qu’on s’éloigne de la fovéa, les cônes deviennent plus rares ; les bâtonnets progressivement prédominent. Ici, les prolongements dendritiques des cellules bipolaires font contact avec un nombre important de bâtonnets.
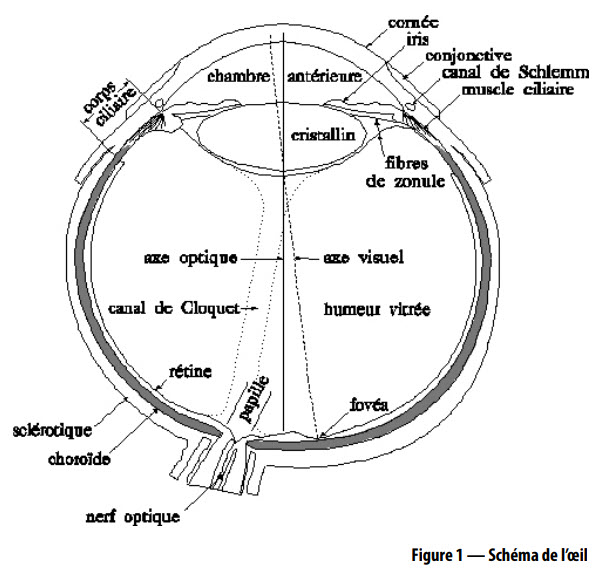
La vision fovéale, donc la vision la plus nette, couvre environ 1° (degré) du champ visuel chez l’Homme. Le champ visuel, incluant la vision périphérique, totalise près de 160°. La dégradation de la netteté se fait progressivement, au rythme d’environ 50% de dégradation par degré d’écartement.
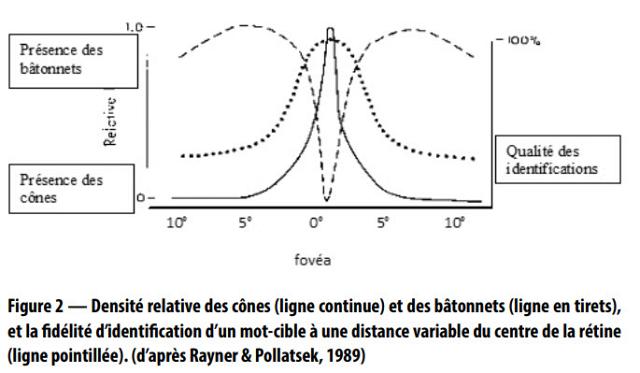
Chez un lecteur expert, la taille de l’empan de lecture peut atteindre 10°. En conséquence, ce lecteur traite des informations très dégradées en bord d’empan, informations provenant de régions plus périphériques. Ces régions sont communément appelées parafovéales. Elles jouent sans conteste un rôle à chaque fixation de l’œil. [3]
2. L’œil se fixe-t-il sur chaque mot d’un texte ?
Il peut sembler commun d’avoir la sensation d’avoir perçu et, donc, explicitement traité, chacun des mots du texte qu’on parcourt. Pourtant, il n’en est rien et cette idée trop simple, si elle rentre en cohérence avec certaines approches ascendantes de la lecture (ou des actions humaines en général) défendues par certains, est démentie par de nombreuses expérimentations. Bien (trop ?) des expériences en psycholinguistiques s’intéressent à la reconnaissance de mots isolés, dans des dispositifs expérimentaux nécessairement réducteurs. Il importe pour ces recherches que l’œil fasse une fixation sur chacun des mots présentés. Ce qui ne permet en rien le syllogisme qui consiste à affirmer, maintenant qu’on sait enregistrer des mouvements extrêmement rapides, que l’œil se pose pratiquement sur tous les mots du texte [4], ce qui reste donc une extrapolation particulièrement audacieuse des travaux de recherche en cours.
En effet, le pourcentage de mots courts sautés (en situation de lecture de textes) dans la vision fovéale est relativement élevé.
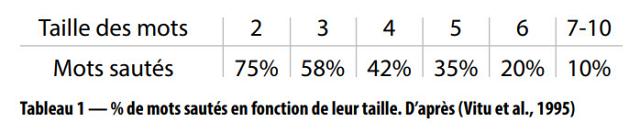
Le tableau ci-dessus montre que si les mots courts (souvent fonctionnels) sont très fréquemment sautés, les mots de plus de 4 lettres, pour la plupart à contenu sémantique, présentent un pourcentage de non-fixation encore important. Qui plus est, bien peu de ces observations intègrent la « vitesse de compréhension » du lecteur. Il semble toutefois qu’un accord existe sur la durée des deux événements repérables : en moyenne, 250 millièmes de seconde pour une fixation et 50 ms pour une saccade de déplacement [5]. Si on tient compte des retours en arrière et des passages à la ligne, on peut considérer qu’il y a, lors d’une lecture libre, environ 13 000 paires, fixation+déplacement, à l’heure. S’il était exact que chaque mot donne « pratiquement » lieu à une fixation, on ne dépasserait pas une vitesse de lecture de 13 000 mots/heure, à comparer à la vitesse de la parole ou à rapporter aux conditions expérimentales (par exemple, en auto présentation segmentée, mot à mot). Pour autant, les bons lecteurs, sans recourir à « l’écrémage » [6], comprennent aisément un texte ordinaire à plus de 20 000 mots/heure, en lecture intégrale. Il semble impossible d’affirmer aujourd’hui que l’œil s’arrête sur tous les mots. Bien au contraire, une recherche conduite, dès 1991, à l’INSERM U305 de Toulouse, sur la coordination binoculaire chez de jeunes lecteurs, apporte des précisions complémentaires. Ces chercheurs tiennent notamment compte de la vitesse de lecture des sujets. « L’amplitude de la saccade de progression détermine la plage de lecture. Plus celle-ci est étendue, plus le nombre de fixations est réduit et plus la lecture est rapide. Les lecteurs lents (vitesse de lecture inférieure à 9 000 mots ! heure) font des saccades de progression de faible amplitude par rapport aux lecteurs rapides (2°39 ’ contre 4 °23 ’) ». Cette amplitude est donnée, ici, en degrés d’arc mesurant l’angle visuel. Dans leur protocole de recherche, une ligne de texte est vue sous un angle de 21°10’ et, par exemple, le mot « les » affiché à l’écran est vu sous un angle de 1°08’. Si une saccade moyenne chez un lecteur lent (2°39’) dépasse déjà la longueur moyenne d’un mot (entre 5 et 6 caractères en français), c’est déjà plus du double chez un enfant de 10 ans, bon lecteur, soit en moyenne 3 mots, ce qui ne signifie pas non plus une amplitude régulière et mécanique des empans mais invalide complètement l’existence d’une fixation par mot. Notons que les meilleurs lecteurs que nous avons pu observer lisaient à des vitesses voisines de 60 000 mots/heure, soit environ 100 signes par seconde. A cette vitesse-là, ils utilisent des empans moyens de 25 signes soit environ 6 mots. De ce rapide calcul, nous pourrions déduire que la taille de l’empan de lecture pour un lecteur véritablement expert est d’environ 10°, soit approximativement la moitié d’une ligne [7]. Le recrutement, par les laboratoires de recherche, des sujets d’expérience se fait, le plus souvent, parmi les étudiants de l’université, sans jamais mesurer leur performance en lecture. Nos propres observations, portant sur des populations de professeurs, montrent une vitesse moyenne de lecture de l’ordre de 12 000 mots par heure. Il est donc probable que les études de psychologie ne tiennent pas assez compte de ce qui se passe ordinairement chez un lecteur expert en situation réelle de lecture. Si l’empan de lecture augmente de façon aussi considérable, peut-on alors se dispenser de s’interroger sur les performances intrinsèques de l’œil ? Et, sur les manières d’entraîner le lecteur à tirer le meilleur parti des différentes informations perçues par l’œil ?
Quid, dans Elsa ?
Depuis toujours, ces séries A et C reposent sur les traitements de zones larges comportant plusieurs mots. La série A propose au lecteur des empans dont la taille est calculée en fonction de sa vitesse de lecture dans la dernière série T. Mais, la première taille du groupe de mots est majorée de deux signes, ce qui force d’entrée le lecteur à augmenter sa quantité d’informations à traiter. Une liste réussie déclenche un léger accroissement du nombre de signes des empans constitutifs de la liste suivante. Une réussite constante à la série A aboutit à une augmentation de huit signes, c’est à dire que l’empan présenté est constitué de un à plusieurs mots supplémentaires. Huit signes de plus par fixation correspond à une augmentation de la vitesse de lecture de l’ordre de 15 000 mots par heure ! Ce qui est loin d’être négligeable ! Certes, dans les conditions de lecture, de nombreux autres facteurs, écartés dans les conditions d’entraînement, modulent la vitesse de lecture mais, la partie technique exercée ici participe fortement à son augmentation. A tout le moins, lire plus vite nécessite obligatoirement d’augmenter la taille de l’empan de lecture, et donc, de traiter plusieurs mots par fixation.
3. La vision parafovéale et la lecture
Quelques équipes de recherche se sont particulièrement spécialisées dans l’étude de la prise parafovéale d’informations lors de la lecture. La question est ici d’étudier le rôle du mot situé à droite (donc, dans la zone parafovéale) de celui fixé (qui se trouve, lui, dans la zone fovéale). Depuis 1981 et les travaux de Rayner, on sait que, si on retire des informations (par des systèmes de masques) de la zone parafovéale, la vitesse de lecture décline d’environ un tiers. Cette réduction de vitesse est due à l’accroissement des temps de fixation et à des saccades oculaires moins amples, donc, à un plus grand nombre de fixations. Les informations sur les mots, fournies par la vision parafovéale, facilitent donc l’identification du mot lorsqu’il entre dans la zone fovéale [8]. On peut se demander par quels mécanismes :
► D’après Inhoff, il paraît improbable que la vue parafovéale active directement une attente sémantique qui accélérerait la reconnaissance du mot [9]. Pour preuve, les bénéfices habituellement observés dus à la vision parafovéale disparaissent si, lors du déplacement de l’œil sur le mot suivant, on remplace celui-ci par un mot sémantiquement proche. Rappelons que l’œil ne prend pas d’information pendant son déplacement [10], ce qui rend « invisible » la substitution.
►On a pu croire que la reconnaissance des mots se faisait de manière séquentielle, un mot après l’autre, ce modèle étant proposé par Taft & Forster. Il s’agirait ici d’un accès dans un fichier qui contiendrait des représentations des radicaux, classées par fréquence. La vision parafovéale aurait donc permis de pré-activer la bonne entrée dans ce « fichier », grâce à la vue anticipée du radical du mot suivant. Inhoff [11] montra que cette hypothèse était fausse. Il rejeta aussi, l’hypothèse de l’influence de la première syllabe comme activation du mot à trouver. « La reconnaissance d’un mot lors de sa fixation n’est pas facilitée par la vision parafovéale antérieure de ses premières lettres, qu’elles forment une syllabe ou non ». [12]
► Des expérimentations plus récentes continuent dans la même veine. On notera en particulier l’article de Kennedy présentant deux nouvelles expériences pour étudier le degré d’influence temporelle d’un mot présenté parafovéalement sur le traitement du mot situé centralement [13]. Ce que cherche à savoir cet auteur, c’est bien si on peut observer le temps pris par le traitement du mot situé en vision périphérique, en fonction de ses caractéristiques propres et abstraction faite du temps de traitement du mot fixé. Dans ces deux expériences, les sujets voient un ensemble de mots de cinq lettres pendant que les mots en vision parafovéale varient sur des critères de longueur, de fréquence et en fonction du type et de la fréquence des trois premières lettres du mot perçu en vision périphérique. Les résultats sont similaires à ceux obtenus par Inhoff onze ans plus tôt : ces auteurs considèrent que le début et la fin des mots contribuent à la reconnaissance périphérique des mots et que les bénéfices dus à la vision parafovéale sont fonction de la totalité de la morphologie du mot. En effet, on obtient de plus grands bénéfices en tenant compte des informations données par l’ensemble du mot périphérique qu’en cumulant les données issues du premier trigramme et de la fin du mot. [14]
• Ce type d’observation renforce les modèles de reconnaissance logographique, développés en leur temps par Adams [15] et McClelland [16]. Ces modèles semblent offrir un point de départ pour la compréhension des bénéfices de la vision parafovéale dans la lecture normale. Par exemple, « toutes les lettres (ou les silhouettes des lettres) d’un mot accessible par la rue périphérique peuvent activer des représentations de lettres (et de possibles représentations lexicales) » [17]. Ces modèles logographiques sont aujourd’hui très décriés, surtout par les modèles développementaux de la lecture. On les considère comme des phénomènes très primitifs (« ...les modalités primitives (logographiques) de traitement de Un formation graphique ») [18], appelés à être remplacés par des modalités grapho-phonologiques ou alphabétiques [19]. On associe, souvent de manière caricaturale, cette capacité logographique à certains types d’enseignement « qui prennent la lecture pour une tâche de mémorisation visuelle » [20]. Pourtant, elles semblent nécessairement à l’œuvre dans la reconnaissance par la vue périphérique, capacité « mathématiquement » indissociable d’une lecture experte.
Enfin, les recherches menées par Kennedy lui font considérer que les effets des zones parafovéales sur les zones fovéales, observés dans les différents travaux expérimentaux, sont incompatibles avec les modèles de lecture dans lesquels l’attention se déplace séquentiellement d’un mot à l’autre. Les données obtenues sont plus congruentes avec l’idée que les processus fovéaux et parafovéaux ont lieu en parallèle sur une région du texte plus large qu’un mot. [21]
Quid, dans eisa ?
Les recherches s’intéressent de plus en plus aux rôles de ces informations perçues par les zones périphériques de l’œil. Si, dans tous les logiciels produits depuis de nombreuses années, l’AFL a toujours essayé d’intégrer cet aspect, force est de constater que les deux nouvelles séries A et C d’EIsa présentent des manières originales d’entraîner cette prise d’informations, en partie grâce à une meilleure compréhension des processus en jeu. Ainsi, la série C introduit de nouvelles modalités d’entraînement Par exemple, il est demandé de reconnaître un empan dans une succession de groupes de mots qui vont apparaître décalés, aléatoirement, à gauche ou à droite, (pour empêcher au sein de l’exercice une routine de s’installer) d’un point de fixation préalable. Par cet artifice d’entraînement, le lecteur est contraint de reconnaître l’empan cible à partir d’informations visuelles nécessairement dégradées puisque présentées à l’extérieur de la zone fovéale. La matérialité des lettres est intacte, mais leur projection sur la rétine est nécessairement floue. Insistons juste un instant ici sur ce qu’on demande au lecteur qui s’entraîne : dans la mesure où Elsa lui présente l’empan à reconnaître, le lecteur se forge un modèle, anticipe des indices éventuellement pertinents à cette reconnaissance dont le processus est ici descendant. Il est à la recherche d’informations pertinentes pour la re-connaissance, ces informations pouvant être présentées dans la zone fovéale ou dans la zone parafovéale.
4. Où fixer ?
Le mécanisme neuronal de production des saccades est contrôlé au moins autant par des neurones excitateurs que par des neurones inhibiteurs. Ainsi, « la dérision de faire un mouvement des yeux, accompagné ou non d’un mouvement de la tête est prise à travers une hiérarchie de mécanismes parallèles excitateurs et inhibiteurs » [22]. Il semble que l’évolution ait amené dans le cerveau des primates un bien plus grand nombre de mécanismes inhibiteurs, ce qui a été utilisé pour « bloquer l’exécution d’un mouvement, de façon à permettre la simulation interne des mouvements planifiés et à tester de façon endogène ses conséquences potentielles » [23]. Ces inhibitions permettent de faire des prédictions et de « sélectionner les stratégies motrices ». De plus, quelques données montrent même, dans certaines conditions, que le cerveau a déjà anticipé sur la deuxième saccade à venir. Ce qui est important, c’est cette capacité du cerveau à simuler les actions à effectuer, dont les saccades oculaires, et à les piloter en fonction du résultat qu’il pense en obtenir. On n’est plus du tout dans une conception mécanique de la saccade, comme une suite de mouvements servant à accumuler de l’information, on est bien dans un mouvement dont les conséquences ont déjà été anticipées. La perception n’est plus seulement préparatoire à l’action, c’est d’abord l’action qui définit la perception dont elle a besoin. Berthoz a résumé ce nouveau modèle en écrivant que « le cerveau n’est pas une machine réactive, c’est une machine proactive qui projette sur le monde ses interrogations ». Une question qui sous-tend nombre de travaux est de distinguer, pour mieux en comprendre leur relation, le moment du déclenchement du mouvement des yeux et l’endroit où ils vont se poser. De nombreux travaux empiriques laissent envisager une relative indépendance entre le « quand » et le « où » [24]. La décision sur le moment du déclenchement de la saccade semble être principalement due à des contraintes cognitives, telles que la complexité du matériau linguistique à traiter pendant la fixation, alors que celle de l’endroit où la prochaine fixation doit se situer semble être influencée par des informations de bas-niveau, telles que l’environnement visuel perçu par la vision parafovéale. C’est sur ce deuxième aspect que les séries A et C d’EIsa interviennent. La longueur du mot situé à droite de la fixation influence le lieu où les yeux vont se poser, donc, la taille de la saccade [25], de telle sorte que cette position d’arrivée est quasi systématique et se situe entre le début et le milieu du mot [26]. Elle a été nommée position préférée du regard [27]. Notons cependant que cette position est une moyenne et que, par exemple, environ 10% des points de fixations sont des espaces. Enfin, d’autres types de travaux ont également montré qu’une combinaison peu fréquente de lettres perçue de manière parafovéale attirait la fixation suivante [28].
Quid, dans elsa ?
Plusieurs nouveaux éléments, en relation avec le « où fixer », font leur apparition dans ces nouvelles séries, tout particulièrement dans la série A. Tout d’abord, alors que dans toutes les versions précédentes, les empans apparaissaient centrés autour du point de fixation, il a été décidé d’attirer le regard du lecteur vers la position préférée du regard telle qu’elle est définie dans la littérature scientifique, c’est-à-dire entre le tiers et le milieu du mot ou du groupe de mots. Ensuite, et surtout, les présentations des empans varient et se dévoilent sous des aspects tout à fait nouveaux : les moments 2 et 3 de la série A invitent successivement à reconnaître des empans présentés uniquement avec la partie supérieure des mots puis, au moyen des seules consonnes. Ce qui s’exerce ici est bien la capacité du lecteur à repérer, lors de la présentation du mot-cible (toujours préalable à la re-connaissance) les éléments visuels saillants qui l’autoriseront à retrouver cette même cible, lorsque les empans seront projetés pendant un temps très court. Quel type de combinaisons particulières de lettres ? Quels éléments discriminants uniquement perceptibles par le haut des mots ou par la structure consonantique ? Encore une fois, réussir ces exercices demande d’être dans un processus descendant : c’est parce qu’on sait, connaît — consciemment ou inconsciemment— les combinaisons de lettres particulières à reconnaître qu’une décision peut se prendre à chaque présentation ultérieure des empans. Les films que nous proposons dans les retours réflexifs de la série A mettent en exergue et conscientisent, comme le faisait le diaporama de l’AFL, l’Acte Lexique, le pouvoir très fortement discriminateur de la zone supérieure des lettres ou de la structure consonantique des mots dans l’écrit français.
PERCEPTION ET ENTRAÎNEMENT À LA PERCEPTION
Il est intéressant de s’arrêter un instant sur le cas des « experts » dans des activités de perception, c’est-à-dire sur des personnes capables de percevoir ce que des novices ne remarquent pas : ce sont les observateurs des oiseaux, les radiologistes, les experts dans l’interprétation des photos aériennes, certains sportifs, les champions d’échecs, les aviateurs, etc [29]. On ne sait pas grand chose sur les mécanismes de perception mis en place par ces experts, même si ce qui les caractérise, c’est d’être très rapides, très précis et, le plus souvent, de manière totalement inconsciente. Quand on leur demande comment ils procèdent, on obtient des réponses évasives, insinuant, semblerait-il, qu’il suffît d’ouvrir les yeux et de regarder ! Néanmoins, les rares recherches disponibles suggèrent que les experts auraient appris à combiner ce vers où (et quoi) il faut diriger l’attention en même temps que la connaissance des différents facteurs qui caractérisent la tâche perceptive à mener [30]. A l’appui de cette hypothèse, les travaux de Chase et Simon montrent que ce qui transparaît chez un maître des échecs, à la fois comme une analyse visuelle ultra-rapide des positions et une mémoire prodigieuse des situations, ne se manifestait jamais quand les pièces étaient placées au hasard sur l’échiquier [31]. Pour ces auteurs, tout se passe comme si les champions d’échecs avaient appris un répertoire très large de patrons d’échiquier qui leur permet de classifier et d’encoder tout nouvel échiquier, à partir du moment où ils respectent les règles de classification. Ce qui est donc particulier dans la vision experte des champions d’échecs, c’est ce système de classification qu’ils ont construit, qui leur permet de reconnaître instantanément tout nouvel échiquier comme plausible et de le mémoriser (probablement en l’intégrant au système de classification).
L’observation de certains sportifs de haut niveau offre aussi l’occasion d’étudier la perception visuelle experte. Il est banal de rappeler qu’une perception rapide et une réaction adaptée sont gages de réussite. Cependant, bien peu de travaux ont envisagé d’observer un grand nombre d’experts pour en extraire une généralisation des processus de traitement rapide de l’information [32]. Dans la plupart des cas, l’étude des différences entre novices et experts reste confinée dans des domaines spécifiques où les experts excellent. Malgré tout, on attribue généralement l’expertise à l’habileté d’anticiper les éléments clés de l’activité. Par exemple, pour la trajectoire du coup droit au tennis, cette anticipation est basée sur l’observation des gestes de l’adversaire qui, à l’intérieur d’un cadre connu par l’expert, doivent orienter la balle de tel ou tel côté [33]. L’expertise visuelle en sport, comme l’expertise du joueur d’échecs, semble reposer en fait sur une expertise non-visuelle pour prévoir, attendre et identifier les seuls événements significatifs. Il s’agit donc d’une capacité acquise à orienter son attention [34]. Notamment, les travaux de Castiello précisent que les athlètes de haut niveau sont capables d’isoler des cibles et de les manipuler simultanément dans des hémisphères séparés. Cet aspect de la perception visuelle (plurimodale ou unimodale) est l’enjeu de différents travaux contradictoires [35] ; cependant, même dans le cas où on suppose que l’attention ne se situe que dans un seul hémisphère, il semble maintenant avéré que le cerveau est susceptible de traiter simultanément l’information de manière très performante dans au moins deux espaces différents.
Le niveau perceptif d’un expert diffère souvent de celui d’un novice par le fait que l’expert a appris où se situaient les informations critiques dans le patron général des stimuli. Dans ces conditions, l’expert peut diriger son attention sur les lieux ou les événements critiques. Biederman & Shiffrar ont réalisé une étude sur les personnes classant les jeunes poulets âgés de quelques jours selon leur sexe. Cette classification semble particulièrement difficile, tellement difficile d’ailleurs qu’il faut des années d’entraînement (consistant à répéter les essais) pour devenir un de ces rares experts. En les étudiant soigneusement, les auteurs ont trouvé que ce qui les distingue, c’est l’habileté qu’ils manifestent concernant d’une part, le lieu de la fixation oculaire et, d’autre part, les éléments saillants qu’ils recherchent. La plupart des experts ne sont en rien conscients de ce qu’ils ont appris durant les années d’entraînement. Biederman et Shiffrar ont montré qu’en disant aux novices où se situaient les informations décisives pour leur activité de différenciation, on leur faisait gagner beaucoup de temps vers l’expertise [36]. Ce que les experts ont appris tacitement par l’expérience et que les novices ont plus rapidement maîtrisé par la transmission des quelques éléments topiques, c’est comment amener le système visuel à la position spatiale exacte et quel type d’informations doit être encodé, ces deux aspects se trouvant en dehors du système visuel lui-même.
Apprentissage perceptif
Il existe une littérature assez abondante sur cette notion d’apprentissage perceptif [37]. Dans une revue consacrée à cette question, Goldstone [38] caractérise cette notion par les changements à long terme d’un système perceptif, ce qui lui permet d’augmenter la qualité de ses réponses à l’environnement. Quatre grands mécanismes visant à améliorer la perception à l’intérieur d’une tâche sous-tendent cet apprentissage perceptif : 1) Une plus grande attention apportée aux formes discriminantes ; 2) Un développement de récepteurs sensoriels spécialisés dans des sous-parties du stimulus ; 3) Une capacité à séparer psychologiquement des stimuli jusqu’alors indistinguables ; 4) Une habileté à détecter une construction unique représentant une configuration complexe, en lieu et place d’une multitude de parties juxtaposées.
Dans les expériences menées sur l’expertise visuelle spatiale [39], l’observation de l’apprentissage perceptif [40] montre que relativement peu d’essais sont nécessaires pour être opérationnel. Cependant, les effets de l’apprentissage ne se transfèrent pas entre différentes tâches requérant de l’hyperacuité visuelle. Dans une tâche visuelle de détection de certaines figures (par exemple, de courtes barres obliques dans un environnement de barres verticales), on mesure la précision, la vitesse et l’insensibilité à la distraction. Ahissar et Hochstein ont étudié l’amélioration par l’entraînement de cette pratique. Comme souvent, ils constatent l’amélioration par la pratique, mais ce qui semble important, c’est que l’amélioration ne se produit que lorsque l’ensemble de la tâche est entraîné, lorsque le rapport entre les cibles est possible : si on entraîne séparément à la détection de deux formes (donc, indépendamment de la discrimination de l’une avec l’autre), on n’observe que peu d’amélioration dans la tâche de départ. Même pour des tâches qui pourraient paraître ne nécessiter que peu de charges cognitives, ces observations confirment le rôle primordial joué par le modèle dans lequel s’intègrent les observations : ce qu’on entraîne, c’est la détection « systémique » des modalités visuelles qui invalident ou corroborent les traitements cognitifs engagés.
Quid, dans elsa ?
Alors, peut-on entraîner cette prise d’informations ? Peut-on développer, améliorer ces aspects a priori très physiologiques ? La réponse est affirmative, mais uniquement dans la mesure où on considère que les processus sont avant tout descendants, qu’ils partent du cerveau vers l’œil et non l’inverse, que c’est le modèle mental qui pilote la prise d’indices. Ce qui ressort de l’observation des experts perceptifs — et de l’apprentissage de cette expertise — c’est bien, d’une part, qu’ils organisent les stimuli par la présence d’un cadre conceptuel et, d’autre part, qu’on peut accélérer la maîtrise de ce cadre en rendant conscientes les informations décisives qui organisent la tâche. [41]
Pour Léontiev, « la prise de conscience d’un contenu est déterminée par la place qu’il occupe dans la structure de l’activité », ce qui implique que ce qui est accommodé dans la conscience d’un élève faisant une activité, c’est « ce qui entre dans l’activité en tant qu’objet d’une action qu’il réalise, en tant que but immédiat de cette action » [42]. Pour cet auteur, un contenu ou un processus qui n’a jamais été amené à un niveau conscient reste « figé, rigide », donc peu manipulable et, surtout, incapable à la fois de réagir de manière créatrice face à un stimulus surprenant et d’améliorer ses propres procédures de traitement. C’est seulement lorsque le processus ou le contenu est susceptible d’être actualisé de manière consciente (le processus devient « éventuellement conscient »), qu’il acquiert la capacité de descendre à un niveau inconscient quand il est requis dans une autre tâche.
C’est ce que ces séries — parmi les autres — veulent travailler : afin d’améliorer l’habileté des lecteurs dans la qualité et l’efficacité de la prise d’informations au moment de la fixation de l’œil (processus inconscient dans une situation de lecture normale), exposer artificiellement à la conscience la partie purement visuelle des éléments qui permettent cette efficacité.
Lors de l’exercice, nous hissons le processus du stade inconscient à celui d’« éventuellement conscient » pour pouvoir travailler sur ces éléments, de façon à permettre au lecteur, en situation réelle, de tirer le meilleur parti de ce qui sera redevenu inconscient mais non ignoré. C’est là toute l’ambition des série A et C du nouvel Elsa.

[1] Perception et lecture, D. Foucambert, A.L. 91, septembre 2005, p. 31.
[2] Berthoz & Petit, 1996.
[3] Certains travaux plus anciens ((Rayner, 1984), cités par (Zagar, 1992)) ont séparé la vision en trois zones bien différenciées : 1) La zone fovéale. 2) La zone parafovéale, plus excentrée (6 à 12 caractères), où se traite principalement l’information donnée par les premières lettres du mot suivant. 3) La zone périphérique, encore plus distante (jusqu’à 20 caractères), dont le rôle se situe plus dans l’extraction de l’information sur la taille des mots pour la programmation des futures saccades.
[4] Gombert, 1996.
[5] Vitu et al., 1990.
[6] Technique de lecture rapide qui consiste à prélever des informations dans un texte par survol ou « lecture en diagonale ».
[7] Pugh, Bassou, Granié, & Morucci, 1991.
[8] Inhoff & Rayner, 1986.
[9] Inhoff, 1982.
[10] Berthoz & Petit, 1996.
[11] Taft & Forster, 1976.
[12] Inhoff, 1989.
[13] Kennedy, 2000.
[14] Ces découvertes se rapprochent de l’effet-mot, qui fait qu’un mot est mieux perçu que l’ensemble des lettres qui le composent (Reichter, 1969).
[15] Adams, 1979.
[16] McClelland & Rumelhart, 1981.
[17] Mnhoff, 1989.
[18] Sprenger-Charolles, 1992.
[19] Frith, 1986 ; Gombert, 1996.
[20] Stuart & Coltheart, 1988.
[21] Kennedy, 2000.
[22] Berthoz & Petit, 1996.
[23] Berthoz 8i Petit, 1996.
[24] Rayner, Sereno, & Raney, 1996 ; Rayner, Fischer, & Pollatsek, 1998.
[25] O’Regan, 1979 ; O’Regan & Jacobs, 1992 ; O’Regan, 1992 ; Rayner & Pollatsek, 1989.
[26] McConkie, Kerr, Reddix, & Zola, 1988 ; O’Regan & Jacobs, 1992 ; O’Regan, 1992 ; Rayner, 1979 ; Vitu, O’Regan, & Mittau, 1990 ; Vitu, O’Regan, Inhoff, &Topolski, 1995.
[27] Rayner, 1979.
[28] Hyona, 1995.
[29] L’essentiel de cette partie est issu de la revue de la littérature faite en 1999 par Pylyshyn.
[30] Haber, 1966.
[31] Chase & Simon, 1973 ; Gobet & Simon, 1998.
[32] Starkes, Allard, Lindley, & O’Reilly, 1994 ; Abernethy, Neil, 8i Koning, 1994.
[33] Abernethy, 1991.
[34] Nougier, Ripoll, & Stein, 1989 ; Castiello & Umiltà, 1992b ; Castiello & Umiltà, 1992a ; Greenfield, deWinstanley, Kilpatruck, & Kaye, 1994.
[35] McCormick, Klein, & Johnston, 1998.
[36] Biederman & Shiffrar, 1987.
[37] « Perceptual learning » est le terme consacré dans la littérature anglo-saxonne.
[38] Goldstone,
1998.
[39] Poggio, Fahle, & Edelman, 1992 ; Fahle, Edelman, & Poggio, 1995.
[40] Dans plusieurs tâches de discrimination spatiale, on observe que le système visuel humain est capable de traiter des relations spatiales avec une précision de l’ordre d’une fraction d’un diamètre de photo-récepteur (Fahle et al., 1995).
[41] Biederman & Shiffrar, 1987.
[42] Léontiev, 1984.